O arquivo robots.txt é uma das peças mais conhecidas do SEO técnico e também uma das mais mal interpretadas. Ele informa aos rastreadores quais caminhos de um site podem ou não ser acessados. Uma única regra incorreta pode impedir que páginas, imagens ou recursos importantes sejam rastreados, reduzindo a capacidade dos mecanismos de busca de compreender o conteúdo.
Ao mesmo tempo, o robots.txt não é uma ferramenta de segurança e não garante que uma URL fique fora do Google. Sua função principal é gerenciar o rastreamento. Para usá-lo corretamente, é preciso entender a diferença entre rastrear, indexar e proteger informações privadas.
O que é robots.txt?
Robots.txt é um arquivo de texto simples disponibilizado na raiz de um site. Antes de acessar páginas e recursos, mecanismos compatíveis com o Protocolo de Exclusão de Robôs podem consultar esse arquivo para identificar as regras aplicáveis ao seu rastreador.
O endereço deve seguir este formato: https://seudominio.com.br/robots.txt. Um arquivo colocado em uma subpasta não controla o site inteiro. Além disso, as regras valem somente para o mesmo protocolo, host e porta em que o arquivo está hospedado. Isso significa que versões com e sem “www” ou subdomínios podem precisar de arquivos próprios.
Segundo a documentação do Google Search Central, o objetivo principal é administrar o tráfego de rastreadores e evitar acessos desnecessários. O arquivo não deve ser usado como única forma de remover uma página dos resultados.
Rastreamento e indexação não são a mesma coisa
Rastreamento acontece quando um mecanismo acessa uma URL e seus recursos para compreender o conteúdo. Indexação é a etapa em que as informações podem ser armazenadas e consideradas para aparecer nos resultados. O robots.txt controla principalmente o primeiro processo.
| Objetivo | Recurso mais adequado | Observação |
|---|---|---|
| Gerenciar acesso de rastreadores a caminhos | robots.txt | A URL ainda pode ser descoberta por links externos |
| Impedir página HTML de aparecer nos resultados | Meta robots noindex | O rastreador precisa conseguir acessar a página para ler a regra |
| Bloquear documento não HTML na indexação | X-Robots-Tag | Enviado no cabeçalho HTTP |
| Proteger conteúdo privado | Login, senha ou controle de acesso | Robots.txt não oferece segurança |
| Remover conteúdo definitivamente | Excluir ou restringir acesso e tratar a URL | Pode exigir solicitação temporária no Search Console |
Uma URL bloqueada por Disallow ainda pode ser descoberta por links internos, externos ou sitemaps. Em determinadas situações, o endereço pode aparecer sem descrição, porque o Google conhece a URL, mas não conseguiu rastrear seu conteúdo. Para impedir a indexação, use noindex ou proteção de acesso conforme o caso.
Onde o arquivo deve ficar?
O robots.txt deve responder na raiz do host com status HTTP adequado e conteúdo em texto simples. O caminho correto para um domínio é /robots.txt. Endereços como /blog/robots.txt não controlam as páginas do domínio principal.
Também é importante evitar redirecionamentos excessivos, erros de servidor e respostas em HTML. A especificação interpretada pelo Google prevê tratamentos diferentes para códigos 2xx, 3xx, 4xx e 5xx. Uma indisponibilidade temporária do arquivo pode alterar o comportamento do rastreamento; portanto, ele precisa ser monitorado como qualquer recurso técnico importante.
Como funciona a sintaxe do robots.txt
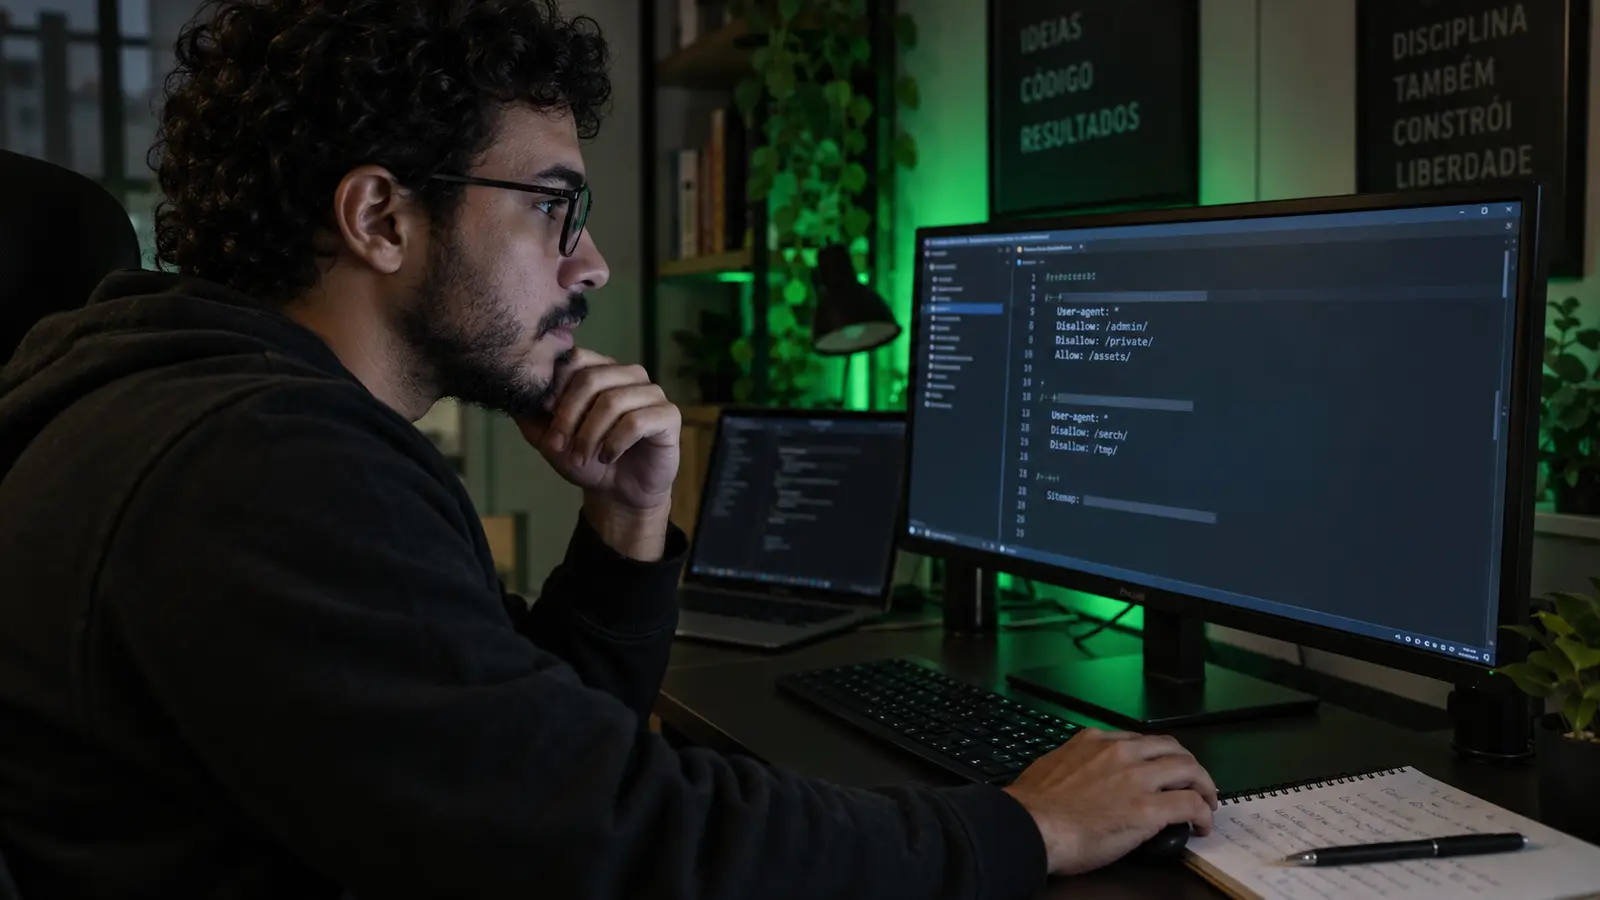
O arquivo organiza regras em grupos. Cada grupo começa com um ou mais campos User-agent, que identificam os rastreadores. Depois aparecem instruções Disallow e Allow. A linha Sitemap pode informar a URL completa do sitemap XML. Comentários começam com o caractere #.
User-agent
Define a qual rastreador o grupo se aplica. O asterisco representa todos os rastreadores que seguem a regra. Um grupo específico pode ser criado para o Googlebot ou outro agente, desde que exista uma necessidade real.
User-agent: *Disallow
Indica um caminho que não deve ser rastreado pelo agente correspondente. Uma barra isolada bloqueia todo o site; por isso, exige atenção máxima. Uma linha vazia após Disallow: não bloqueia caminhos.
User-agent: *
Disallow: /area-interna/
Allow
Libera um caminho mais específico dentro de uma área bloqueada. É útil quando um diretório não deve ser rastreado, mas determinado arquivo ou rota precisa continuar acessível.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap
Aponta para o endereço completo do sitemap XML. A instrução não substitui o envio do sitemap ao Google Search Console, mas facilita sua descoberta. Sites que utilizam Rank Math normalmente possuem um índice em /sitemap_index.xml.
Sitemap: https://seudominio.com.br/sitemap_index.xmlExemplo de robots.txt para WordPress
Uma configuração básica de WordPress pode impedir o rastreamento do painel administrativo e manter liberado o arquivo utilizado por funções públicas. O endereço do sitemap precisa ser substituído pelo domínio real.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://seudominio.com.br/sitemap_index.xml
Esse exemplo não deve ser copiado sem análise. Lojas virtuais, áreas de membros, filtros, buscas internas e ambientes com subdomínios podem exigir outras decisões. Além disso, bloquear parâmetros ou páginas duplicadas no robots.txt não resolve automaticamente canonicalização e indexação.
Como o robots.txt funciona no WordPress?
Quando não existe um arquivo físico na raiz, o WordPress pode gerar uma versão virtual em /robots.txt. Plugins de SEO também podem oferecer uma área para edição ou aplicar filtros sobre esse conteúdo. Antes de criar um arquivo manual, verifique qual solução já está respondendo à URL para evitar fontes de configuração concorrentes.
No painel do WordPress, a opção “Desencorajar os mecanismos de busca de indexar este site” merece atenção. Ela é útil em ambientes de desenvolvimento, mas pode prejudicar o projeto se permanecer ativada após a publicação. A configuração não substitui uma estratégia de rastreamento; seu objetivo é desencorajar a visibilidade do site.
O Rank Math permite gerenciar configurações relacionadas ao robots.txt e ao sitemap. Mesmo assim, qualquer alteração deve ser conferida diretamente no endereço público do arquivo. Em um trabalho de assessoria de SEO, essa verificação deve fazer parte da auditoria técnica.
Erros de robots.txt que prejudicam o SEO
1. Bloquear o site inteiro por engano
A regra Disallow: / impede o rastreamento de todos os caminhos daquele grupo. Ela costuma aparecer em ambientes de teste e pode ser levada para produção durante uma migração. Após publicar ou reformular um site, verifique imediatamente o arquivo.
2. Bloquear CSS, JavaScript e imagens essenciais
O Google precisa acessar recursos importantes para renderizar a página de forma semelhante a um navegador. Bloquear diretórios inteiros como /wp-content/ ou /wp-includes/ pode esconder estilos, scripts e imagens necessários para interpretar layout, conteúdo e experiência mobile.
3. Usar robots.txt para esconder informações privadas
As regras são públicas e podem ser visualizadas por qualquer pessoa. Elas não impedem acesso humano nem obrigam rastreadores maliciosos a obedecer. Contratos, dados de clientes, documentos internos e páginas administrativas precisam de autenticação e permissões reais.
4. Combinar Disallow e noindex de forma contraditória
Se uma página está bloqueada no robots.txt, o Google pode não conseguir acessá-la para ler a meta tag noindex. Quando a intenção é remover uma página HTML dos resultados, permita o rastreamento até que a regra de não indexação seja processada.
5. Informar caminhos incorretos
A correspondência considera caminhos e diferencia letras maiúsculas e minúsculas. Erros de digitação, barras ausentes e regras amplas podem produzir um resultado diferente do esperado. Teste URLs reais, não apenas a aparência do arquivo.
6. Bloquear páginas que geram negócio
Páginas de serviços, produtos, categorias e artigos precisam ser rastreáveis para competir organicamente. Uma alteração feita para reduzir URLs duplicadas pode atingir todo um diretório comercial. O diagnóstico deve cruzar regras, sitemap, links internos e relatórios de indexação.
7. Manter regras antigas após mudanças no site
Migrações, novos plugins e alterações de estrutura podem tornar o arquivo obsoleto. Uma pasta que antes continha páginas internas pode passar a hospedar recursos públicos. O robots.txt precisa acompanhar a arquitetura atual.
Como testar o robots.txt
O primeiro passo é abrir o arquivo no navegador e confirmar se ele responde em https://seudominio.com.br/robots.txt. Depois, compare cada regra com URLs reais do site. No Google Search Console, a Inspeção de URL ajuda a observar se uma página pode ser acessada e quais condições afetaram sua indexação.
Uma rotina segura inclui:
- Confirmar o status HTTP e o tipo de conteúdo retornado.
- Verificar se existe apenas uma fonte efetiva de configuração.
- Testar páginas de serviço, artigos, categorias, imagens e recursos.
- Comparar caminhos bloqueados com as URLs presentes no sitemap.
- Inspecionar páginas importantes no Google Search Console.
- Revisar regras após migrações, alterações de domínio ou lançamento.
- Guardar uma cópia da configuração anterior antes de editar.
Robots.txt melhora o posicionamento?
O arquivo não aumenta posições diretamente apenas por existir. Seu valor está em evitar bloqueios e orientar o acesso a partes relevantes, especialmente em sites grandes ou com muitas URLs geradas por filtros e parâmetros. Em sites pequenos, um arquivo simples e correto costuma ser melhor do que uma longa lista de regras sem necessidade.
SEO técnico cria condições para que o conteúdo seja descoberto e compreendido. Depois disso, relevância, qualidade, autoridade e experiência continuam determinantes. Para entender o conjunto, consulte o artigo como aparecer no Google e o guia de SEO on-page.
Quando usar robots.txt, noindex ou proteção por senha?
- Robots.txt: para administrar rastreamento de caminhos e recursos que não precisam ser acessados.
- Noindex: para permitir o acesso do robô, mas solicitar que uma página não apareça nos resultados.
- X-Robots-Tag: para aplicar regras de indexação a PDFs, imagens e outros arquivos por cabeçalho HTTP.
- Senha ou autenticação: para conteúdo privado, confidencial ou restrito a clientes.
- Remoção da URL: quando o conteúdo deixou de existir e deve receber redirecionamento ou status apropriado.
Escolher a ferramenta errada é uma causa frequente de problemas. Antes de editar, defina claramente se o objetivo é reduzir rastreamento, impedir indexação, consolidar duplicidades ou proteger dados. Cada finalidade exige uma solução diferente.
Conclusão: pequenas regras podem causar grandes impactos
O robots.txt é simples no formato, mas estratégico no efeito. Ele informa aos rastreadores quais caminhos podem ser acessados, ajuda a administrar o tráfego de crawl e pode indicar o sitemap. Ao mesmo tempo, não substitui noindex, canonical, autenticação ou uma arquitetura bem planejada.
Em WordPress, verifique a versão pública do arquivo, o plugin de SEO, as configurações de leitura e o sitemap. Evite regras copiadas sem contexto e revise tudo depois de mudanças importantes. Se você suspeita que páginas relevantes estão bloqueadas ou fora do Google, solicite uma auditoria técnica de SEO da ARTEWEBMIDIA para identificar o problema antes que ele afete tráfego e oportunidades.